欢迎您访问《智慧农业(中英文)》官方网站! English

基于领域HyDE查询增强与LightRAG的水稻种植检索增强生成方法

  • 裴丽娜 1 ,
  • 淦欣喆 , 1 ,
  • 陈明 , 1, 2 ,
  • 郭钦鸿 1
展开
  • 1. 上海海洋大学信息学院,上海 201306,中国
  • 2. 农业农村部渔业信息重点实验室,上海 201306,中国
陈明,博士,教授,研究方向为水产物联网、数据挖掘、大模型等。E-mail:。
淦欣喆,硕士研究生,研究方向为大模型与知识图谱应用。E-mail:。

裴丽娜,硕士,研究方向为质量评价、品质研究、数据库等。E-mail:。

收稿日期: 2026-06-18

  网络出版日期: 2026-10-09

基金资助

国家重点研发计划项目“大口黑鲈和罗非鱼种质资源挖掘、遗传鉴定和利用”(2022YFD2400801)

广东省重点领域研发计划项目“陆基池塘智慧养殖场关键技术研究与示范”(2021B0202070001)

A Retrieval-Augmented Generation Method for Rice Cultivation Based on Domain-HyDE Query Enhancement and LightRAG

  • PEI Lina 1 ,
  • GAN Xinzhe , 1 ,
  • CHEN Ming , 1, 2 ,
  • GUO Qinhong 1
Expand
  • 1. College of Information Technology, Shanghai Ocean University, Shanghai 201306, China
  • 2. Key Laboratory of Fisheries Information, Ministry of Agriculture and Rural Affairs, Shanghai 201306, China
CHEN Ming, E-mail: .
GAN Xinzhe, E-mail: .

PEI Lina, E-mail: .

Received date: 2026-06-18

  Online published: 2026-10-09

Supported by

National Key Research and Development Program of China "Germplasm Resource Mining, Genetic Identification and Utilization of Largemouth Bass and Tilapia"(2022YFD2400801)

Guangdong Provincial Key-Area R&D Program "Key Technologies and Demonstration of Smart Land-Based Pond Aquaculture Farms"(2021B0202070001)

Copyright

copyright©2026 by the authors

摘要

【目的/意义】 针对水稻种植智能问答中短查询专业术语不足、用户表达与领域知识表述不一致以及复杂问题证据召回不充分等问题,研究领域假设性文档嵌入(Hypothetical Document Embeddings,HyDE)与简单高效的检索增强生成框架(Simple and Fast Retrieval-Augmented Generation,LightRAG)的融合方法,分析领域适配与关系检索的增量作用。 【方法】 以通义千问2.5系列70亿参数指令模型(Qwen2.5-7B-Instruct)为基座,采用低秩适应(Low-Rank Adaptation,LoRA)生成领域假设性文档,通过主题和实体关键词检索证据,并以排序融合与字符预算组织上下文。在100题水稻种植开放性问题测试集上比较五种方法,开展逐题统计分析、60题关系分层诊断及固定条件关系通道消融。 【结果和讨论】 领域HyDE+LightRAG与LightRAG的三维平均分分别为3.629和3.515,多重比较校正后差异不显著(p=0.903)。LightRAG较朴素检索方法提高0.893分(校正后p<0.001)。60题诊断中前8项召回率由0.829升至0.885;100题消融增量为0.022 5,95%置信区间为[0.000 0, 0.055 0]。 【结论】 领域HyDE能够补充专业术语和隐含条件,但在当前同域、小样本和稀疏图谱条件下,相对LightRAG尚未表现出稳定显著优势。系统主要增益来自LightRAG,关系通道仅提供有限排序辅助,不足以支持稳定的高层关系推理。少样本方法可作为资源受限时领域LoRA适配的低成本替代方案。

本文引用格式

裴丽娜 , 淦欣喆 , 陈明 , 郭钦鸿 . 基于领域HyDE查询增强与LightRAG的水稻种植检索增强生成方法[J]. 智慧农业, 2026 : 1 -18 . DOI: 10.12133/j.smartag.SA202606037

Abstract

[Objective] Rice cultivation question answering often starts from short, colloquial, or underspecified user queries. Such queries may omit agronomic terminology, growth-stage constraints, environmental conditions, or the management objectives that are needed to retrieve relevant evidence. This study develops and diagnoses a retrieval-augmented generation (RAG) workflow that combines hypothetical document embeddings (HyDE) with the Simple and Fast Retrieval-Augmented Generation framework (LightRAG), while deliberately positioning the main contribution on the query side rather than claiming new high-level graph reasoning. The study asks three questions: whether LightRAG accounts for most of the improvement over flat text retrieval; whether a domain low-rank adaptation (LoRA)-HyDE generator adds a measurable benefit over LightRAG, generic HyDE, or Few-shot HyDE with a fixed prompt; and whether relation information remains useful when the underlying rice knowledge graph is sparse. [Methods] Qwen2.5-7B-Instruct was used as the common base model. A LoRA adapter trained on rice-cultivation question–hypothetical-document pairs generated retrieval-oriented documents that supplemented the original query with domain terms, potential application conditions, and management intents. High-level topic keywords and low-level entity keywords were extracted from the original and hypothetical texts. They were used to query the relation, entity, and text-chunk indexes in LightRAG. Candidate evidence was organized using fixed limits on the top K ranked candidates (TopK), weighted ranking, reciprocal rank fusion (RRF), a character budget, deduplication, and source metadata. The audited Neo4j graph contained 11 682 nodes and 14 043 relationships. Its average undirected degree was 2.310, 14.732% of nodes were isolated, the average clustering coefficient was 0.032 5, and 2 284 connected components were present. These values were treated as structural limitations rather than evidence of graph quality. The main evaluation used the fixed 100-question Rice Cultivation Open Questions Test Set (RCOQ-H100). Answers from Naive RAG, LightRAG, generic HyDE plus LightRAG, fixed three-example Few-shot HyDE plus LightRAG, and domain LoRA-HyDE plus LightRAG were rated anonymously by two agronomy experts and three independent large language model (LLM) raters. Question-level bootstrap confidence intervals, two-sided Wilcoxon tests with Holm correction across all ten pairwise comparisons, and Cohen's dz were reported. A separate, expert-checked 60-question balanced diagnostic contained twenty 0-hop, twenty 1-hop, and twenty 2-hop-or-more questions. It was frozen before any system answers were generated and was used to compare an entity–text baseline with relation-augmented retrieval at Top-8. The longest-common-subsequence variant of Recall-Oriented Understudy for Gisting Evaluation (ROUGE-L) and the semantic matching metric BERTScore, based on Bidirectional Encoder Representations from Transformers (BERT), were additionally calculated as reference-keypoint overlap measures; they were not interpreted as agronomic correctness or evidence of faithfulness. [Results and Discussions] The mean three-dimensional score was 3.629/5 for domain LoRA-HyDE plus LightRAG, 3.515/5 for LightRAG, 3.489/5 for generic HyDE plus LightRAG, 3.437/5 for Few-shot HyDE plus LightRAG, and 2.622/5 for Naive RAG. LightRAG exceeded Naive RAG by 0.893 points, with a 95% confidence interval of [0.692, 1.101], a Holm-adjusted p value below 0.001, and Cohen's dz of 0.852. This comparison accounts for most of the observed performance gain and reflects the capability of the existing LightRAG framework rather than a new contribution of the present study. Domain LoRA-HyDE exceeded LightRAG by only 0.115 points; the 95% confidence interval was [-0.077, 0.305], the raw p value was 0.226, the Holm-adjusted p value was 0.903, and Cohen's dz was 0.118. Domain LoRA-HyDE differed from generic HyDE by 0.141 points, with a 95% confidence interval crossing zero, while it differed from Few-shot HyDE by 0.192 points, with a 95% confidence interval of [-0.010, 0.389] and a Holm-adjusted p value of 0.099. Generic HyDE scored 0.026 points below LightRAG; this small, non-significant direction suggests that generated query terms may introduce drift or noise, but it does not establish a stable negative effect. In the independent 60-question diagnostic, the predefined graph-path coverage was 100% for all three hop strata. Overall recall among the top eight retrieved chunks (Recall@8) increased from 0.829 for entity–text retrieval to 0.885 for relation-augmented retrieval, a paired increase of 0.056 with a 95% confidence interval of [0.012, 0.117]. The 2-hop-or-more point estimate was positive, but its interval included zero. ROUGE-L and BERTScore likewise did not support the superiority of domain HyDE over LightRAG. In the expert-validated and frozen RCOQ-H100, the distribution of 0-hop/1-hop/2-hop-or-more questions was 59/2/39. Under a fixed-condition relation-channel ablation, overall Recall@8 increased by 0.022 5, with a 95% bootstrap interval of [0.000 0, 0.055 0], supporting only limited ranking assistance. The validation covered questions, reference key points, gold chunks, relation paths, and hop labels, but not a new blind rating of the 100×5 system answers; existing subjective ratings and the new stratified retrieval results were therefore reported by the experimental batch. [Conclusions] Under the present same-domain, small-sample, and sparse-graph conditions, domain LoRA-HyDE shows only a weak positive trend in blinded ratings, and the incremental differences over LightRAG, generic HyDE, and Few-shot HyDE are not statistically significant after multiplicity correction. The defensible contribution is therefore an engineering implementation and a diagnostic evaluation of query-side semantic supplementation with HyDE. Relation information provides limited assistance in evidence ranking in the current graph, but the evidence does not support claims of activated high-level graph reasoning or significantly improved coordinated recall. Fixed Few-shot HyDE is a cost-effective alternative when training resources are limited. The potential of LoRA adaptation and relation retrieval should be reevaluated with larger training data, better-connected graphs, more sensitive external evaluations, and independent document sources.

0 引 言

水稻是全球最重要的口粮作物之一,其稳产高产直接关系到粮食安全和农业生产韧性[1]。随着品种选育、栽培调控、土壤肥料、病虫害防控和农业气象等研究的持续推进,水稻种植知识不断积累,并分散存在于论文、标准、专著、品种审定公告和农技服务案例中[2]。如何将这些知识转化为依据明确、措施可执行且来源可追溯的专业答案,已成为农业智能问答的重要需求。
检索增强生成(Retrieval-Augmented Generation,RAG)通过将大语言模型(Large Language Model,LLM)的参数化知识与外部知识检索相结合,为缓解知识滞后、提升生成内容可追溯性提供了有效路径[3]。相关研究已在医学[4]、法律[5]和教育[6]领域开展应用评估,并总结了其技术体系与挑战[7]。然而,传统RAG主要基于原始查询召回平面文本块,难以显式表达品种、环境、措施、病虫害和产量之间的条件关系与因果联系。当查询涉及干旱保产、低温应对或病虫害综合防控等复合问题时,文本块检索往往只能提供局部证据,难以形成稳定的知识链条。
为组织实体、关系与文本片段,图检索增强生成(Graph Retrieval-Augmented Generation,GraphRAG)、简单高效的检索增强生成框架(Simple and Fast Retrieval-Augmented Generation,LightRAG)和混合检索增强生成(Hybrid Retrieval-Augmented Generation,HybridRAG)等方法引入了结构化检索,其中GraphRAG通过社区摘要支持局部与全局检索,LightRAG以低层实体检索和高层关系检索形成轻量化双层检索范式[8-10]。图结构可提供跨片段知识链条,但检索效果取决于查询能否触发相关实体和语义边,也受到图谱连通性与关系质量约束。在稀疏图谱中,高层关系检索可能主要返回单跳相邻关系,其相对于实体和文本检索的边际作用需要单独诊断。若原始问题缺少专业术语或适用条件,仍可能出现检索入口偏移和证据召回不足。
假设性文档嵌入(Hypothetical Document Embeddings,HyDE)[11]先由生成模型将短查询扩展为假设性文档,再利用其语义表示引导检索,可在缺少相关性标注时改善查询与目标文档的语义对齐。低秩适应(Low-Rank Adaptation,LoRA)则通过训练少量低秩参数实现领域适配,为构建农业领域HyDE模型提供了低成本途径[12];自适应参数预算分配[13]与微调方法综述[14]为方案选择提供参考,通义千问2.5(Qwen2.5)技术报告[15]则说明了所用基座模型。但由通用模型生成假设性文档时,可能出现术语泛化、事实偏移或措施适用条件缺失等问题,从而将不准确语义引入检索链路。
现有研究涵盖检索增强预训练[16]、按问题复杂度自适应检索[17]、查询重写[18]、词法检索与重排序[19,20],并进一步探索自反思生成[21]、自动评价[22]及迭代检索生成[23],并在农业问答中验证了外部知识增强与复杂度路由的可行性[24,25];图检索研究则系统总结了实体、关系与文本协同召回机制[26]。与此同时,量化低秩适应(Quantized Low-Rank Adaptation,QLoRA)、权重分解低秩适应(Weight-Decomposed Low-Rank Adaptation,DoRA)等方法为降低适配开销提供了技术路径[27,28];医疗[29]、法律[30]和金融[31]领域研究展示了大模型的领域应用潜力,多语言嵌入模型则为检索表示提供了支撑[32]。这些工作为本研究提供了技术基础,但水稻种植问答中领域化查询增强与稀疏图谱关系检索的增量作用仍缺少受控诊断。综上,现有研究主要存在三方面不足:一是短查询中的隐含条件和专业语义难以充分表达,影响实体、关系和文本证据的召回;二是标准HyDE难以保证农业假设性文档的领域一致性;三是领域适配的增量作用及关系检索在稀疏农业图谱中的边际贡献仍缺少受控诊断。针对这些问题,本研究将核心工作定位为查询端HyDE语义补充的工程实现与诊断,并以LightRAG作为既有结构化检索基础,形成“知识支撑—查询增强—证据检索—受控生成”的技术流程,主要工作如下:
(1)实现面向水稻种植问答的查询端HyDE语义增强流程,将领域假设性文档生成、关键词补充和LightRAG证据检索整合为可复现的实验链路。
(2)构建面向HyDE环节的水稻领域生成模型。以通义千问2.5系列70亿参数指令模型(Qwen2.5-7B-Instruct)为基座,通过LoRA在 water_rice_zh_demo数据集上微调,从查询端补充专业术语、适用条件和隐含场景表达。
(3)实现实体、关系和文本块候选的检索与证据融合流程,采用固定前K项筛选(TopK Selection,TopK)、实体、关系加权映射、倒数排名融合(Reciprocal Rank Fusion,RRF)、去重和字符预算筛选候选证据,并单独诊断关系信息的有限边际作用。
(4)构建基于100题水稻种植开放性问题测试集(Rice Cultivation Open Questions Test Set,RCOQ-H100)的固定盲评流程,并对缺少逐题源块的题目开展结果盲证据审计,使100题均具有标准金源块和0-hop/1-hop/2-hop+标签,用于分层检索复核;同时保留少样本学习(Few-shot Learning)替代性分析、LoRA秩敏感性分析、关系通道固定条件消融和参考要点重合度诊断,以界定结论边界。

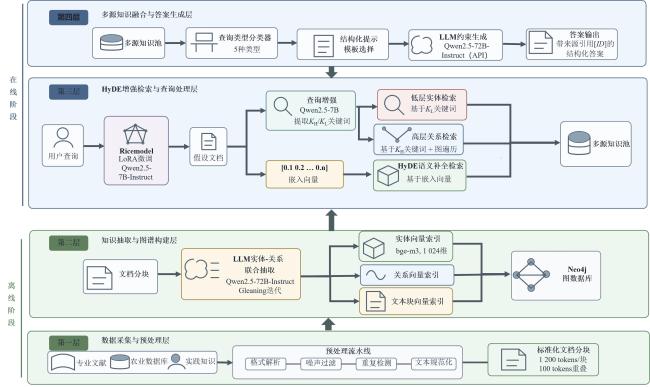
1 HyDE-LightRAG系统与双层检索增强生成方法

本章对系统总体设计与核心方法进行统一阐述。系统按照“知识索引构建—领域HyDE查询增强—双层图检索—证据融合与受控生成”的流程运行,整体架构如图1所示。离线阶段将水稻种植资料处理为实体节点、语义边和文本块三类索引;在线阶段利用水稻领域模型将用户短查询扩展为假设性文档,再由高层关键词和低层关键词分别触发关系检索与实体检索,并通过文本块检索补充原文依据;最终,生成模型仅在证据上下文内组织答案和来源引用。需要说明的是,双层检索沿用LightRAG既有架构;本研究重点评估查询端HyDE的增量作用,并不预设稀疏图谱能够形成高层关系推理。
图 1 HyDE-LightRAG 系统总体技术架构图

Fig. 1 General Technical Architecture Diagram for the HyDE-LightRAG System

1.1 领域数据预处理与知识索引构建

系统采集水稻种植领域多源知识并进行标准化处理,数据来源包括专著、论文、技术标准、品种审定公告、病虫害图谱、农业气象数据和基层农技案例等,覆盖品种、栽培、土肥、病虫害防控和环境调控等知识场景。原始文档经光学字符识别(Optical Character Recognition,OCR)、格式转换、噪声过滤、近似重复检测和文本规范化后,按词元(token)滑动窗口并结合章节、段落边界分块,同时保留源文件路径、分块序号和token计数等元数据,以支持来源回溯。知识图谱仅作为证据组织和结构化检索的支撑层。系统将大的抽取文本块转化成小的文本块和实体(节点)和关系(语义边),并保留来源文件、分块编号和节点—语义边出处等元数据;构建流程为“领域文本分块—节点与语义边抽取—规范化合并—图存储与向量索引”,为实体、关系与原文证据检索提供统一候选空间。
节点—语义边抽取采用基于提示工程驱动的Qwen2.5-72B-Instruct模型,将文档分块、节点与语义边类别、输出格式约束及少量示例拼接为统一提示。为减少随机遗漏和同义重复,系统进一步执行迭代补偿抽取(Gleaning迭代)与规范化合并。节点类别涵盖品种资源、栽培措施、病虫草害、生育时期、环境条件、农资投入品、土壤属性、产量性状、区域位置和生理过程10类;语义边类型包括致因、抑制、促进、适配、施用、作用、属性和时序等。原始Neo4j数据库审计得到11 682个节点和14 043条语义边。存储层采用Neo4j保存节点、语义边及来源信息,并支持局部邻接扩展和关系路径查询;索引层分别为实体、关系和文本块构建bge-m3嵌入索引,用于定位具体对象、召回关系线索并补充原文细节。图数据库与向量索引共同构成HyDE-LightRAG检索阶段的候选证据池。
图谱规模并非本研究的主要贡献,仅视为可检索证据空间的基础条件。研究重点是利用领域HyDE生成的语义信号更准确地触发实体、关系和文本块证据;节点抽取准确性、语义边类型一致性、同义归并错误率和来源回溯准确率仍需抽样核验,并作为后续提升可复现性和可迁移性的重点。

1.2 HyDE 增强检索与查询处理层

检索增强层承接第1.1节形成的实体、关系和文本块候选空间,在线流程包括查询语义补全、候选证据触发与有限上下文筛选。水稻领域模型仅承担查询端增强任务:当原始查询较短、偏口语化或缺少专业术语时生成假设性文档h,补充对象、场景、适用条件和潜在管理意图。例如,“干旱条件下如何保产”可扩展为水分管理、抗旱品种、根系活力和叶面补肥等检索线索。
通用模型联合分析原始查询q与假设性文档h,输出增强查询q′、高层主题关键词K H和低层实体关键词K L,分别用于表达主题条件关系和定位具体对象。增强查询随后进入文本块、实体和关系向量索引,实体与关系命中项映射回来源文本块;标准LightRAG按文本、实体和关系分数加权排序,领域方案再与字符n-gram最佳匹配25(Best Matching 25,BM25)结果进行RRF融合,并经固定TopK、去重和字符预算筛选。在对比实验中,知识库、嵌入模型、生成模型和答案约束提示保持一致,HyDE-LightRAG与LightRAG的主要差异限定在查询端假设性文档生成与关键词增强。查询增强与检索入口的具体设计如下。设用户原始查询为q,水稻领域模型表示为Md,通用查询增强模型表示为Mg。系统首先根据公式(1)生成假设性文档h,再按公式(2)从q与h中得到增强查询q′、高层关键词K H和低层关键词K L。该环节发生在任何向量检索之前,作用是把用户表达转换为更接近水稻知识库表述方式的检索信号。
h = M d q ; θ d
式中:q为用户原始查询;Md 为经LoRA微调的水稻领域模型;θd 为Md 的模型参数;h为模型针对q生成的水稻种植假设性文档。q和h均为文本序列,不限定数值取值范围。
为降低单一路径造成漏召回的风险,系统同时调用LightRAG原有的关键词抽取模块,获得另一组高层主题关键词和低层实体关键词。随后需确定最终参与检索的关键词集合,公式(3)用于完成去重合并:若水稻领域模型补充了专业术语,而LightRAG抽取了原问题中的显式对象,则二者均予以保留;若出现重复或近似表达,则保留规范化后的统一关键词。
q ' , K H , K L = M g q , h ; θ g
式中:q′为融合原始查询与假设性文档后的增强查询;K H和K L分别为高层主题关键词集合和低层实体关键词集合;Mg 为通用查询增强模型;θg 为Mg 的模型参数;q和h的含义同公式(1)。各关键词集合均为有限集合,其元素数量由具体查询决定,不限定固定数值范围。
K H ' = U n i q u e K H ⋃ K H 0 , K L ' = U n i q u e K L ⋃ K L 0
式中:K′ H和K′ L分别为最终用于检索的高层关键词集合和低层关键词集合;K H和K L为领域HyDE路径生成的关键词集合;K H 0和K L 0为LightRAG原有模块抽取的关键词集合;∪表示集合并运算;Unique表示规范化、近义项合并与去重操作。集合的基数为非负整数,实际大小随查询变化。
完成关键词构建后,系统评估实体节点、语义边或文本块与当前问题的相关程度,将查询表达和候选对象描述编码为向量,并依据公式(4)计算余弦相似度。相似度越高,候选证据进入后续筛选的概率越高。
s i m q ' , d = E q ' ⋅ E ( d ) E q ' 2 E ( d ) 2
式中:sim表示余弦相似度;q′为增强查询;d为候选实体、关系或文本块的文本描述;E为bge-m3嵌入编码函数;·表示向量点积;‖·‖2表示L2范数。余弦相似度的理论取值范围为[-1,1],数值越大表示语义相关性越高;本研究不设置独立的绝对相似度阈值。
朴素检索增强生成(Naive Retrieval-Augmented Generation,Naive RAG)作为仅检索文本块的基线。在具体筛选时,公式(5)~(7)分别对实体、关系和直接文本块进行相似度排序。实际RCOQ-H100运行未设置独立绝对相似度阈值:实体候选ke =8,关系候选kr =8,LightRAG直接文本候选kc =5(Naive RAG直接取8项),最终均截断为Top-8。
V q = T o p K e ∈ V ,   k e s i m q ' , d e
式中:Vq 为查询q对应的实体候选集合;V为知识图谱中的全部实体节点集合;e为任一候选实体,且e∈V;de 为实体e的文本描述;ke 为实体候选数量,本研究固定取8;TopK表示按相似度由高到低选取前ke 项。相似度范围同公式(4),为[-1,1]。
R q = T o p K r ∈ R ,   k r s i m q ' , d r
式中:Rq 为查询q对应的关系候选集合;R为知识图谱中的全部语义边集合;r为任一候选关系,且r∈R;dr 为关系r的文本描述;kr 为关系候选数量,本研究固定取8;TopK表示按相似度由高到低选取前kr 项。相似度范围同公式(4),为[-1,1]。
C q = T o p K c ∈ C ,   k c s i m q ' , d c
式中:Cq 为查询q对应的直接文本块候选集合;C为知识库中的全部文本块集合;c为任一候选文本块,且c∈C;dc 为文本块c的文本描述;kc 为直接文本候选数量,LightRAG配置取5,Naive RAG配置取8;TopK表示按相似度由高到低选取前kc 项。相似度范围同公式(4),为[-1,1]。
候选实体和关系先依据来源标识符(Identifier,ID)映射为文本块。标准LightRAG对直接文本、实体来源和关系来源分数分别赋予1.00、0.60和0.45的权重,并取最大值形成领域排序D;领域词法融合配置再将D与字符n-gram BM25排序B进行RRF重排。公式(8)给出冻结配置的实际计算,其中rank不存在时,该通道不贡献分数。
S q = T o p K c ,   8 1 5 + r a n k D ( c ) + 0.5 5 + r a n k B ( c )
式中:Sq 为查询q对应的融合排序后证据集合;c为候选文本块;D为直接文本、实体来源和关系来源加权形成的领域排序;B为字符n-gram BM25排序;rankD(c)和rankB(c)分别为文本块c在两种排序中的名次,均为从1开始的正整数;常数5为RRF平滑项,0.5为词法排序权重;TopK(c,8)表示保留融合得分最高的8个文本块。某通道无对应名次时,该通道贡献为0;融合得分的理论范围为[0,0.25]。
在生成前,领域融合配置按排序依次写入证据,并执行公式(9)的字符预算:每个文本块正文最多保留1 200字符,加入chunk ID后累计上下文不超过5 000字符。该预算只改变进入提示词的证据长度,不改变检索排序。
需要说明的是,公式(5)~(9)现已按RCOQ-H100实际运行脚本表述,不再使用未启用的τₑ、τᵣ和τc,也不将字符预算写成token预算。实际运行参数及开发集敏感性分析在实验部分报告。
∑ c ∈ S ' q L e n c h a r [ i d c ] ⊕ c 1 : 1200 ≤ 5000
式中:S′q 为满足字符预算后实际写入生成提示的证据子集;Lenchar表示字符串字符数;id c为文本块c的来源标识;⊕表示字符串拼接;c 1:1200表示文本块c最多保留前1 200个字符。单个文本块正文长度范围为0~1 200个字符,包含来源标识后的累计上下文长度范围为0~5 000个字符。上述关键判定量、取值规则及依据汇总于表1。
表1 HyDE-LightRAG关键判定量与取值依据

Table 1 Key evaluation metrics and rationale for value selection in HyDE-LightRAG

计算量 判定规则 依据
实体是否召回 sim(q′, de ) 按相似度取实体Top-8 低层关键词反映具体实体和术语
语义边是否召回 sim(q′, dr ) 按相似度取关系Top-8 高层关键词反映主题、因果和关联意图
文本块是否补充 sim(q′, dc ) LightRAG直接文本候选Top-5;Naive RAG为Top-8 补充原文证据并弥补图抽取遗漏
证据是否进入上下文 加权排序、RRF与Lenchar 最终Top-8;领域融合上下文≤5 000字符,单块≤1 200字符 控制LLM输入长度和噪声
答案可信性判定 F claim(a, Sq ) 论断支持度取0、0.5或1并计算平均 降低专业领域知识幻觉

1.3 多源知识融合、答案生成与评价准则

答案生成层将已筛选证据转化为可读、可追溯的农业技术回答。将HyDE假设性文档、实体证据、关系证据、文本块证据和来源元数据分区写入提示词;技术指导类按“适用条件—操作措施—注意事项”组织,品种选择、病虫害防治或环境适应类按“对象特征—影响因素—管理建议”组织。实体证据支撑具体对象和事实,关系证据提供原因、条件和措施之间的联系,文本块证据补充用量、阶段、注意事项和来源位置。
若检索结果只覆盖部分问题,系统要求明确区分已有证据支持的内容与需要进一步核验的内容;当上下文没有对应依据时,不得编造试验数据、品种表现或用药剂量。最终输出包括直接回答、分条措施、适用条件和来源引用编号;引用由节点、语义边或文本块元数据提供,以支持回溯原始资料。
在证据支持度方面,系统通过提示词要求最终答案仅依据证据集合Sq 作答并标注chunk ID;运行代码不在线计算论断相似度阈值。离线忠实度核对将答案拆分为m个最小可核查论断aj,并仅依据该答案实际可见的检索证据,将Sup(aj )标记为支持(1)、部分支持(0.5)或不支持(0)。公式(10)用于计算论断级证据支持比例。
F c l a i m a , S q = 1 m ∑ j = 1 m S u p ( a j ) ,   S u p ( a j ) ∈ 0,0.5,1
式中:F claim(a,Sq )为答案a相对于证据集合Sq 的论断级证据支持比例;a为待评价答案;m为答案中最小可核查论断的数量,m为正整数;j为论断序号,取1~m;aj 为第j个最小可核查论断;Sup(aj )为该论断的支持度,取值为0、0.5或1,分别表示不支持、部分支持和支持。F claim的取值范围为0~1。
公式(10)仅用于离线评价,不参与检索截断或在线答案过滤。本研究以固定随机种子从H区和X区各抽取40题,对80题的五种匿名回答进行论断级自动预标注,记录支持、部分支持和不支持的论断数量,作为答案证据一致性的补充指标。
实验阶段从正确性(Correctness,Cor)、完整性(Completeness,Com)和实用性(Usefulness,Use)三个维度评价系统答案,各维度均采用1~5分量表。设第m位评分者对第i题、第d个维度的评分为sm , i , d,三个维度等权;每个方法的最终得分为100题和5位评分者的宏平均。三维平均分按公式(11)计算。
S c o r e = C o r + C o m + U s e 3
式中:Score为单个回答的三维平均分;Cor、Com和Use分别为正确性、完整性和实用性评分,均取1~5的整数。由于三个维度等权,Score的取值范围为1~5,数值越大表示回答的综合质量越高。
公式(11)将正确性、完整性和实用性合成为单个回答的三维平均分。评分时不向评分者提供方法名称,答案在每题内随机映射为A~E;汇总后再依据内部盲化映射还原方法。
为降低自动评分偏差,评分时应将不同系统的答案匿名化并随机排序,评价提示中不提供模型名称,仅要求评价模型依据问题、答案内容和可见证据进行打分。需要强调的是,大模型辅助评价只能反映当前评价提示和评价模型偏好下的相对质量,不能完全替代农学专家评审;涉及用药剂量、品种适宜区和灾害应对等生产安全相关论断时,只有具有检索来源支撑的内容才应作为正向评价依据。

1.4 基于水稻领域模型的领域HyDE实现

领域HyDE仅用于生成面向检索的假设性文档h,不替代最终问答模型。用户查询q先输入水稻领域模型得到h,再由通用模型从q和h中分别抽取高层主题关键词与低层实体关键词,使检索由“原始短查询匹配”转化为“领域语义文档驱动匹配”。例如,对于“干旱条件下如何保产”,可由h补充水分管理、根系活力、抗旱品种和叶面补肥等线索,为公式(5)~(7)的实体、关系和文本块检索提供更完整的专业入口。
本研究采用模型分工策略:水稻领域模型负责领域化假设性文档生成,通用大语言模型负责关键词规整、证据上下文组织和最终答案生成。水稻领域模型以Qwen2.5-7B-Instruct为基础,采用LoRA在water_rice_zh_demo数据集上微调;该数据集由水稻栽培专业资料转换而成,覆盖栽培技术、品种选择、病虫害防治和生长环境等内容,其用途是提高假设性文档的专业语义覆盖能力,而非训练模型记忆最终答案。模型训练后固定用于在线查询增强,参数见表2。
表 2 水稻领域模型的LoRA微调关键参数配置

Table 2 Key LoRA fine-tuning parameters of the rice-domain model

参数 数值
秩(rank) 16
缩放参数(alpha) 32
丢弃概率(dropout) 0.05
LoRA目标模块 q_proj、k_proj、v_proj、o_proj、gate_proj、up_proj、down_proj
学习率 2e-4
批量大小 1×8(梯度累积,有效批量为8)
混合精度 16位脑浮点格式(16-bit Brain Floating Point, BF16)
量化 未量化
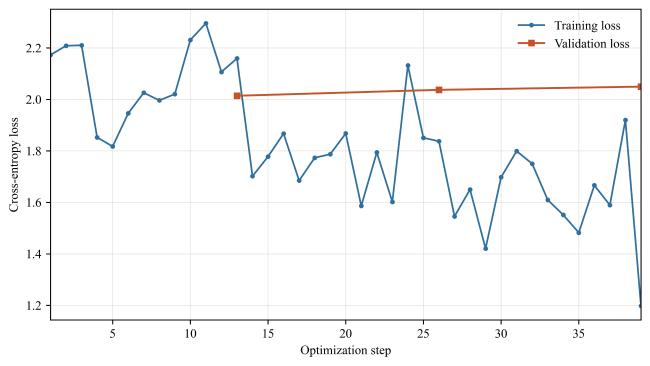
模型训练共进行3个轮次(epoch),包含39个优化步,训练集平均损失为1.825。第1、2和3个轮次的验证损失分别为2.014、2.037和2.050;加载适配器后的最终验证损失为2.049 5,低于未加载适配器时的验证损失2.496 6。图2展示了实际训练与验证损失记录。训练损失总体下降,而验证损失在第1个轮次后未继续下降,说明继续增加训练轮数可能带来过拟合,后续实验固定使用3个轮次训练后所得的适配器,以保持配置一致;该设置不表示其验证性能最优。
图2 水稻领域模型训练与验证损失曲线

Fig. 2 Training and validation loss curves of the rice-domain model

为检验LoRA是否可由提示学习替代,本研究补充比较了通用HyDE、Few-shot HyDE和领域LoRA-HyDE。Few-shot组采用固定3条示例进行诊断,其实现规则见第2.2节。领域LoRA模型仅用于生成检索假设性文档,最终答案仍基于检索证据约束生成。相关数据集、训练参数和比较结果见第2.3节。

2 实验结果与分析

2.1 实验环境与知识图谱基础

LoRA训练和RCOQ-H100的本地生成均使用NVIDIA RTX A6000图形处理器(Graphics Processing Unit,GPU),软件环境为Python 3.12、PyTorch、统一计算设备架构(Compute Unified Device Architecture,CUDA)、Ollama和Neo4j图数据库。图谱抽取调用Qwen2.5-72B-Instruct;通用HyDE、Few-shot HyDE、领域HyDE和最终答案生成,均以本地Qwen2.5-7B-Instruct为基座。其中,最终答案生成时关闭LoRA适配器;嵌入模型为bge-m3,嵌入维度为1 024。
为支撑实体检索、关系检索和文本块补充,本研究基于水稻种植领域文本构建知识图谱。经原始Neo4j数据库复核,图谱共包含11 682个节点(nodes)和14 043条边(edges),主要节点类别、语义边类别及其在检索中的作用见表3,完整拓扑统计将在后文报告。
表3 水稻种植知识图谱主要节点类别与语义边类别

Table 3 Main node categories and semantic edge categories of rice cultivation knowledge graph

对象 主要类别 检索作用
节点 栽培措施 支撑栽培措施和农事操作检索
节点 生育时期 支撑返青、分蘖、孕穗和抽穗等时期管理检索
节点 环境条件 支撑气象、土壤和胁迫条件检索
节点 品种资源、病虫草害、产量性状等 支撑品种选择、防控和产量问题检索
关系 措施适配关联 支撑技术措施与适用对象之间的关联召回
关系 生育时期关联 支撑不同生育时期的管理知识组织
关系 病虫草害治理关联 支撑病虫草害识别、防控和用药知识检索
关系 综合语义关联 支撑时序、条件、作用和效果关系检索
表3显示,节点类别主要用于实体定位,语义边类别提供条件、因果和操作关系的候选线索。本研究不将图谱规模或关系类型本身视为性能证据,而将其作为后续受控比较的检索空间。鉴于图谱平均度和聚类系数较低,高层关系检索在当前结构上的增益预期有限,其相对“实体—文本”检索的作用由第2.4节关系跳数分层诊断单独报告。

2.2 对比实验

在方法性能比较方面,主比较包括Naive RAG、LightRAG、通用HyDE+LightRAG和领域HyDE+LightRAG四组,另设Few-shot HyDE+LightRAG,用于诊断上下文学习对LoRA的替代程度。由于本研究关注开放性、综合性农业问答,采用正确性、完整性和实用性三维评分,评价生成答案质量,并结合逐题统计与证据支持性分析解释结果。
历史稿件曾将开放性评测表述为240题,但该早期记录未保留可复现的逐题清单与筛选链路,故本研究不将其与当前测试集作同集比较。本研究最终使用经农学专家逐题核定并冻结的RCOQ-H100。该测试集共100题,前50题来自既有同域评测,后50题为来源约束问题。后50题的精确源文本块未进入LoRA训练样本,但其中1份来源文档与LoRA训练来源重合,故RCOQ-H100仅作为同域固定评测。针对前50题缺少逐题金源块的问题,本研究在不使用任何系统Top-8检索结果、回答或评分的前提下开展证据审计:15题原样接受、22题收窄后接受、13题因冻结语料不足而按相同关系跳数替换。最终100题均绑定参考要点、金源块、路径实体和关系跳数,其构成为0-hop 59题、1-hop 2题、2-hop+39题;75个唯一金源块在文本块存储、实际LightRAG运行投影和Neo4j审计投影中均可追溯。为降低泄漏与调参偏差,LoRA数据按源文档划分,前50题的近重复问题在训练集构建前排除;字符n-gram BM25融合权重和RRF参数仅在H001~H025上选择,H026~H050及X001~X050不参与配置选择。新增分层检索与客观指标均基于RCOQ-H100;证据核定前完成的既有人工评分与核定后新增的检索和客观指标,按实验批次分别统计,不跨批次迁移评分。
Few-shot HyDE使用与通用HyDE相同的Qwen2.5-7B-Instruct基座、系统提示、192 token生成上限、TopK=8和确定性解码,并固定使用前3个“问题—假设性文档”示例。既有人工评分采用逐题随机匿名方式,由两位农学专家和Gemini 3.5 Flash、GPT-5.6 Sol、DeepSeek-V4-Flash[33]三位大模型评委完成。RCOQ-H100已重新生成100题×5种主方法的匿名评分逗号分隔值(Comma-Separated Values,CSV)文件,但本轮专家核定对象为题目、参考要点、金源块、关系路径和跳数标签,不包括对新100×5系统答案的重新盲评。因此,既有主观评分仅用于其对应的实验批次,不与新增分层检索结果合并;若报告新答案的主观比较,需另行完成独立盲评。既有盲评批次的五种方法评分结果见表4。
表 4 RCOQ-H100匿名多评委评分结果

Table 4 Blinded multi-rater results on RCOQ-H100

方法 正确性 完整性 实用性 三维平均分
领域HyDE+LightRAG(词法融合,冻结配置) 3.626 3.576 3.686 3.629
LightRAG 3.504 3.456 3.584 3.515
通用HyDE+LightRAG 3.474 3.444 3.548 3.489
Few-shot HyDE+LightRAG(诊断组) 3.434 3.388 3.490 3.437
Naive RAG 2.604 2.572 2.690 2.622

注:各维度采用1~5分量表,各维度均值由100题和5位评分者等权汇总;三维平均分由三个维度等权计算。均值保留三位小数,差值按未四舍五入的均值计算;两位人工评分者为农学专家,每道题的5种候选回答均独立随机映射为A~E,全部评分完成后统一解盲。

表4显示,领域HyDE+LightRAG三维平均分为3.629/5,LightRAG、通用HyDE、Few-shot HyDE和Naive RAG分别为3.515/5、3.489/5、3.437/5和2.622/5;五个评分源均将领域HyDE+LightRAG列为第一。该结果仅反映当前同域知识库、固定问题与冻结配置下的描述性排序,不等同于跨来源泛化或农技处方有效性。
对500个“问题-方法”答案单元,五个评分源的绝对一致型单测量组内相关系数(Intraclass Correlation Coefficient,ICC),即ICC(A,1)为0.550,两位农学专家组的ICC为0.686,三位模型评委组的ICC为0.448;两位专家组的均分与三个模型评委组均分的逐项Spearman相关系数为0.843(p<0.001)。DeepSeek-V4-Flash与Gemini 3.5 Flash、DeepSeek-V4-Flash与GPT-5.6 Sol、Gemini 3.5 Flash与GPT-5.6 Sol在三个整数评分维度上的完全一致率分别为44.5%、32.6%和26.3%,评分相差不超过1分的比例分别为91.3%、76.7%和62.9%。
逐题配对分析覆盖五种方法的全部10组两两比较。领域HyDE+LightRAG相对LightRAG、通用HyDE和Few-shot的均值差分别为0.115、0.141和0.192分,95%置信区间分别为[-0.077,0.305]、[-0.040,0.325]和[-0.010,0.389],均跨越0;与LightRAG比较的原始p=0.226,Holm校正p值分别为0.903、0.746和0.099,效应量dz分别为0.118、0.150和0.186,均不支持存在显著增量;LightRAG相对Naive RAG高0.893分,95%置信区间为[0.692,1.101],Holm校正后p<0.001。因此,领域HyDE仅表现出微弱的正向点估计,可确认主要增益来自既有LightRAG检索框架。
在案例分析方面,为展示具体农业问答中的差异,本研究选取“在干旱条件下如何保证水稻正常生长?”作为典型查询,表5展示了Naive RAG、LightRAG与领域HyDE+LightRAG的回答对比。
表5 案例研究:不同方法回答摘要对比

Table 5 Case study: Comparison of answer summaries among different methods

方法类型 回答内容
Naive RAG

在干旱条件下,确保水稻正常生长需要综合运用多种灌溉技术和管理措施。根据提供的文档内容,适时的灌溉管理和科学施肥是关键环节。

插秧后的2至5天内进行第一次灌溉,以维持土壤湿润度,防止因风干引起的稻苗损伤,并帮助新根系快速生长和稳定。初次灌水量要适中,保持田面有薄层水即可。

在整个秧苗生长期,根据天气状况、土壤湿度及水稻生长状态灵活调整灌溉策略。干旱条件下应适当增加灌溉次数,确保水肥供应充足……

LightRAG

在干旱条件下保证水稻正常生长,需要综合考虑水源、土壤和肥料管理等多个方面。

一、科学灌溉:采用浅水勤灌的方式,可以有效提高水稻对水分的吸收效率,同时避免过度湿润导致根系生长不良或病害的发生。……在水资源紧张的情况下,滴灌是一种高效的灌溉方式。

二、施肥管理:干旱条件下施用肥料应以有机肥为主,并根据土壤测试结果科学施用化肥。……在干旱期间,应避免一次大量施肥导致土壤过于湿润……

三、病虫害防治:……

领域HyDE+LightRAG 在干旱条件下,应优先围绕水源保障、关键生育期保水、土壤墒情监测和养分调控制定综合管理方案。(1)水分管理:根据移栽返青、分蘖、孕穗和抽穗等关键时期调整灌溉策略,在水源不足时优先保障对产量形成影响较大的阶段;可采用浅水湿润或干湿交替管理,避免长期断水造成根系和叶片受损。(2)根系和养分调控:在干旱胁迫下避免一次性大量施肥,宜结合土壤肥力和苗情进行分次追肥;叶面肥、微量元素或调节剂的使用应依据检索来源、产品标签和地方农技建议确定,不能脱离品种和生育时期给出固定剂量。(3)品种与田间管理:在易旱区域优先选择经当地审定或示范验证的耐旱、节水型品种,配合整地保墒、合理密植和覆盖保墒等措施。(4)风险监测:持续关注高温、大风、病虫害和土壤水分变化,必要时结合地方农技部门意见调整灌溉、追肥和防控方案。该回答将干旱管理拆分为水分、养分、品种和风险监测等证据链条,并对缺乏来源支撑的具体剂量保持保守表述。
评估结果

正确性:回答能够围绕干旱胁迫下的水分、关键生育期和养分管理组织内容,但具体剂量仍需来源核验。

完整性:回答覆盖水分、养分、品种和风险监测等主要环节。

实用性:回答给出分层管理思路,同时明确应结合当地条件、产品标签和农技建议。

表5中LightRAG原始回答将大量施肥与土壤过湿直接关联,存在因果表述错误;其关于干旱与过湿的表述也未区分缺水背景和局部灌溉条件。此处保留原始输出以展示模型缺陷,相关内容不作为农艺建议。由表5可知,领域HyDE+LightRAG在该案例中围绕水分管理、关键生育期保水、养分调控、品种选择和气象监测分层组织回答,并补充土壤墒情、根系活力等专业线索,同时提示结合当地气候、品种与农技规范调整方案。该案例仅说明回答组织方式和专业线索覆盖的差异,不替代后文的总体配对检验,也不能区分关系检索与HyDE的因果贡献;具体肥料、调节剂或农药建议仍应以检索来源、地方标准和专家核验为准。

2.3 消融实验

为分析查询增强方法与图检索的贡献,本研究在相同知识库、嵌入模型、回答生成模型和输出预算下设置四组核心消融实验:Naive RAG仅进行文本块向量检索;LightRAG使用实体、关系和文本块协同检索;通用HyDE+LightRAG由未微调Qwen2.5-7B-Instruct生成假设性文档;领域HyDE+LightRAG使用冻结LoRA适配器及开发集冻结的词法融合配置。Few-shot组使用未微调基座和固定3条示例,仅用于诊断LoRA的必要性。
核心消融与少样本诊断结果见表6。表6显示,LightRAG较Naive RAG高0.893分,95%置信区间为[0.692,1.101],Holm校正后p<0.001,效应量dz=0.852,表明既有LightRAG结构化检索可能贡献了大部分观察到的增益;RCOQ-H100核心消融未单独隔离关系检索相对“实体—文本”基线的因果贡献,因此不能将该差异表述为本研究“双层图检索”的新增贡献。
表 6 四组核心消融与Few-shot诊断结果

Table 6 Four core ablations and the Few-shot diagnostic results

方法 是否使用LightRAG HyDE来源 RCOQ-H100三维平均分/分 排序
Naive RAG 否 无 2.622 5
LightRAG 是 无 3.515 2
通用HyDE+LightRAG 是 未微调Qwen2.5-7B-Instruct 3.489 3
领域HyDE+LightRAG 是 LoRA适配器(冻结) 3.629 1
Few-shot HyDE+LightRAG(诊断) 是 未微调Qwen2.5-7B-Instruct+固定3条问题—假设性文档示例 3.437 4
领域HyDE相对LightRAG、通用HyDE和Few-shot HyDE分别高0.115、0.141和0.192分,但95%置信区间均跨越0,Holm校正后p值分别为0.903、0.746和0.099,仅能表述为微弱正向趋势。在102条训练样本的小规模设定下,Few-shot可能是资源受限场景下替代LoRA的更具性价比的方案。通用HyDE均值略低于LightRAG(-0.026分),但差异不显著,最多提示假设性文档可能引入查询漂移或噪声。综合证据将本研究贡献限定为查询端HyDE语义补充的工程实现与诊断分析。

2.4 实验与可复现性分析

图谱拓扑采用最终Neo4j物理审计投影:11 682个节点、14 043条关系、2 284个连通分量,其中最大连通分量8 346个节点和1 721个孤立节点(占14.732%);无向平均度为2.310,平均聚类系数为0.032 5。实际检索使用的LightRAG运行缓存投影为10 723个节点、10 955条边和2 194个连通分量,两者是不同的实体—关系投影,不作同一运行图混写。两种投影共享同一组341个来源文本块,RCOQ-H100的75个唯一金源块在二者中均100%可追溯,但来源空间对齐不证明节点、关系或路径一一等价。150个金源块中139个同时关联最大连通分量与碎片区域,100题中96题具有此类来源暴露;该统计不等于问题的目标实体位于碎片区域,也不证明系统实际完成关系路径遍历。上述稀疏性和投影差异要求将关系检索定位为有限证据组织辅助,而非稳定高层推理。原始知识图谱的完整拓扑统计见表7。
表 7 原始水稻知识图谱拓扑审计

Table 7 Topological audit of the original rice knowledge graph

指标 数值 统计口径
节点数 11 682 Neo4j原始计数
关系数 14 043 Neo4j原始计数
无向唯一边 13 495 合并方向重复后计数
孤立节点 1 721(14.732%) 无向度为0
最大连通分量 8 346(71.443%) 无向连通分量
连通分量数 2 284 无向连通分量
平均无向度 2.310 2E/N,E=13 495(无向唯一边)
平均聚类系数 0.032 5 无向图
最大连通分量直径 20 最大连通分量(Largest Connected Component,LCC)的无向最短路径
在LoRA数据与实际训练方面,RCOQ-H100中的领域HyDE使用冻结的v1适配器。water_rice_zh_demo v1按源文档划分训练集与验证集,问题文本与假设性文档长度采用Qwen2.5 tokenizer统计;训练采用16位脑浮点格式(16-bit Brain Floating Point, BF16),未进行模型量化。相关样本统计与训练配置见表8。
表 8 water_rice_zh_demo v1数据集与实际LoRA训练统计

Table 8 Statistics of the water_rice_zh_demo v1 dataset and actual LoRA training

统计项 数值
总样本数 133个问答/假设性文档对
训练/验证/测试 102 / 14 / 17(按源文档划分)
平均问题长度 27.23字符;17.71个Qwen token
平均假设性文档长度 181.87字符;124.62个Qwen token
LoRA配置 r=16,alpha=32,dropout=0.05;q/k/v/o/gate/up/down_proj
实际训练 3 epoch,学习率2e-4,有效批量8,最大长度1 024,BF16,未量化
验证损失 基座2.496 6;适配器2.049 5
表8中的17个测试样本是water_rice_zh_demo用于HyDE假设性文档生成的按源文档的留出集,与主实验RCOQ-H100用途不同,既不是RCOQ-H100的子集,也不是其扩展。训练集仅102条,验证集和测试集分别为14条和17条,难以保证7B模型形成稳定、可泛化的领域知识表征,评估也易受单个样本和随机划分影响。因此,本研究将LoRA定位为查询表达适配,而非领域知识记忆。
r=16是主实验冻结前采用的初始配置。为检验其是否偏大,在相同数据划分、训练轮数和解码条件下补充r=4、8和16敏感性实验。在17条留出集的摘要召回评价指标(Recall-Oriented Understudy for Gisting Evaluation,ROUGE)的最长公共子序列版本ROUGE-L分别为0.285、0.286和0.279,基于Transformer的双向编码器表征(Bidirectional Encoder Representations from Transformers,BERT)的语义匹配评分BERTScore-F1分别为0.737、0.742和0.736;r=4或8相对r=16的成对差异区间均跨越0,双侧Wilcoxon p为0.263~0.611。该诊断不支持r=16最优,也未显示较小秩导致性能下降。
在长度、检索与统计方面,五种方法按表4所列顺序的平均字符数分别为274.88、249.75、252.21、246.71和251.87。采用Qwen2.5 tokenizer且不添加特殊符号统计500个答案,完整token分布将在后文报告。在线性长度控制模型中,token长度系数为-0.001 64分/token(按问题聚类稳健标准误((Standard Error,SE)=0.000 93);领域配置相对LightRAG、通用HyDE、Few-shot和Naive的长度调整后优势分别为0.144、0.165、0.224和1.039分。结果表明,领域HyDE+LightRAG的排序并非由回答较长单独造成,但逐题配对非参数检验仍是主要比较依据。五种方法的逐题两两配对统计见表9。
表 9 RCOQ-H100五种方法的逐题两两配对统计

Table 9 Question-level statistics for all pairwise comparisons of the five methods on RCOQ-H100

比较(左-右) 均值差 Bootstrap 95%置信区间(Confidence Interval,CI) Wilcoxon p(原始/Holm) Cohen dz
领域-LightRAG 0.115 [-0.077, 0.305] 0.226 / 0.903 0.118
领域-通用HyDE 0.141 [-0.040, 0.325] 0.149 / 0.746 0.150
领域-Few-shot 0.192 [-0.010, 0.389] 0.016 5 / 0.099 0.186
领域-Naive 1.007 [0.809, 1.212] <0.001 / <0.001 0.968
LightRAG-通用HyDE 0.026 [-0.134, 0.188] 0.707 / 1.000 0.032
LightRAG-Few-shot 0.077 [-0.086, 0.242] 0.269 / 0.903 0.093
LightRAG-Naive 0.893 [0.692, 1.101] <0.001 / <0.001 0.852
通用HyDE-Few-shot 0.051 [-0.084, 0.187] 0.513 / 1.000 0.073
通用HyDE-Naive 0.867 [0.668, 1.071] <0.001 / <0.001 0.846
Few-shot-Naive 0.815 [0.627, 1.012] <0.001 / <0.001 0.815

注:表9中,“领域”“通用HyDE”和“Few-shot”分别指领域HyDE+LightRAG、通用HyDE+LightRAG和Few-shot HyDE+LightRAG,“Naive”指Naive RAG;均值差及其置信区间以分计,p值和效应量为无量纲数值。

答案长度回归以500个“题目—方法”记录为样本,因变量为五个评分源在三个维度的等权平均分。自变量为方法指示变量和中心化Qwen token长度,以领域HyDE+LightRAG为参照,并按题目进行聚类稳健标准误估计。该模型仅用于长度敏感性诊断分析,不能替代表9的逐题配对检验结果。
检索评价采用召回率(Recall)、命中率(Hit Rate,Hit)、平均倒数排名(Mean Reciprocal Rank,MRR)和归一化折损累积增益(Normalized Discounted Cumulative Gain,NDCG),均为无量纲指标;后缀@8表示仅评价前8项检索结果。为直接回答RCOQ-H100是否回避复杂关系问题,本研究按预定义跳数复跑检索,并以结果生成前固定的金源块计算Top-8指标。五种标准方法共得到500条唯一记录,另完成100条领域HyDE+LightRAG固定词法融合记录,无重复键或空答案。表10列出了总体复核结果;后文进一步给出59道0-hop、2道1-hop和39道2-hop+的覆盖与召回率Recall@8。由于1-hop仅2题,分层数值仅作描述。以下结果作为新增的独立分层检索实验报告,不与证据核定前完成的主观评分合并。
表 10 RCOQ-H100总体检索复核(Top-8)

Table 10 Overall retrieval re-evaluation on RCOQ-H100 (Top-8)

方法 召回率Recall@8 Hit@8 MRR@8 NDCG@8
Naive RAG 0.045 0.050 0.011 0.018
LightRAG 0.497 0.580 0.121 0.207
通用HyDE+LightRAG 0.476 0.560 0.109 0.192
Few-shot HyDE+LightRAG 0.484 0.590 0.113 0.195
领域HyDE+LightRAG(固定词法融合) 0.646 0.740 0.577 0.554
表10中的Recall@8、Hit@8、MRR@8和NDCG@8分别表示前8项检索结果的召回率、命中率、平均倒数排名和归一化折损累积增益,均为取值0~1的无量纲指标。表10表明,LightRAG相对Naive RAG贡献主要检索增益。通用HyDE、Few-shot HyDE和不含固定词法融合的领域HyDE均未稳定超过LightRAG;最终领域HyDE+LightRAG管线在固定词法融合后取得较高Recall@8和NDCG@8,但该管线使用5 000字符总预算,而标准方法沿用既有配置且未采用相同的总字符预算,因此,该表仅用于工程管线复核,不构成“仅改变HyDE”或“仅改变关系通道”的纯因果消融实验。实际超参数与敏感性见表11;关系通道的独立边际作用以后文的固定条件消融结果为准。
表 11 RCOQ-H100实际运行参数

Table 11 Actual runtime parameters for RCOQ-H100

项目 实际取值
图谱抽取模型 Qwen/Qwen2.5-72B-Instruct(API)
HyDE与答案基座 Qwen2.5-7B-Instruct;领域HyDE加载LoRA,最终答案关闭适配器
嵌入模型 bge-m3,1 024维
标准检索 最终TopK=8;直接文本候选5;实体和关系候选各8;权重0.60/0.45
领域词法融合 语义与字符n-gram BM25各取16项;词法权重0.5;RRF k=5
相似度阈值 τₑ、τᵣ、τc未独立启用;由TopK和融合排序截断
上下文预算 单块最多1 200字符;领域融合总预算5 000字符
生成长度 HyDE 192 token;增强查询128 token;最终答案256 token
解码方式 do_sample=False,确定性贪心解码,不设置采样温度
配置选择 仅H001~H025;其余75题不参与融合参数选择
知识库分块 评测阶段沿用冻结文本块、chunk ID及来源映射
融合参数在H001~H025开发集上从18组候选配置中选择,H026~H050及X001~X050不参与选择。表12列出代表性配置的开发集NDCG@8,结果表明性能对词法权重和RRF参数存在一定敏感性,最终采用词法权重为0.5和RRF参数k=5。
表 12 词法融合参数敏感性(H001~H025开发集)

Table 12 Sensitivity of lexical-fusion parameters on the H001-H025 development set

词法权重 RRF k NDCG@8(无量纲)
0.25 5 0.516 8
0.50 5 0.524 4(选用)
0.50 20 0.503 0
0.75 5 0.471 3
1.00 20 0.448 3

注:五种方法的答案长度分布见表13,长度以Qwen2.5分词器统计的token数计。

表 13 RCOQ-H100答案token长度分布

Table 13 Token-length distributions of RCOQ-H100 answers

方法 (均值±标准差)/token

中位数[四分位距]

/token

第5~95百分位数/token 最小~最大/token
领域HyDE+LightRAG(词法融合) 194.4±57.8 201.0 [150.0, 256.0] 96.0~256.0 67~256
LightRAG 176.5±61.9 173.5 [128.5, 237.0] 72.8~256.0 43~256
通用HyDE+LightRAG 179.4±57.5 176.5 [134.8, 235.0] 90.9~256.0 60~256
Few-shot HyDE+LightRAG 175.1±58.3 176.0 [131.0, 222.0] 75.7~256.0 52~256
Naive RAG 175.1±58.9 172.0 [124.8, 232.2] 88.0~256.0 72~256
在答案忠实度方面,依据公式(10),80题×5种回答的盲态自动预标注中,领域HyDE、Few-shot HyDE、通用HyDE、Naive RAG和LightRAG的论断级微平均证据支持率分别为0.686、0.578、0.565、0.561和0.532;领域HyDE+LightRAG固定词法融合配置(词法权重0.5,RRF参数k=5)的回答级平均支持率为0.674,题目bootstrap 95%置信区间为[0.637,0.710]。该结果作为自动化证据一致性分析,不并入表4的人工答案质量评分。
与相关RAG方法的定性比较方面,表14从任务对象、查询增强、检索架构、图结构作用和适用边界进行对等比较。杨俊等[25]提出的方法侧重按问题复杂度选择单跳或多跳混合检索,本研究侧重水稻问答中的查询端HyDE术语补充与稀疏图谱诊断,二者在适用场景上形成互补。由于实验设置差异,本研究不将所提方法的评分与上述文献报告的数值进行直接对比。
表14 相关RAG方法的定性比较

Table 14 Qualitative comparison of related RAG methods

方法名称 任务对象 查询增强方式 检索架构 图结构作用 适用边界
杨俊等[25] 农作物病虫害问答 按问题复杂度路由 BM25单跳/多跳混合检索 用于检索路径组织,非实体—关系双层检索核心 侧重复杂度路由,适合病虫害问答
ReG-RAG[24] 农业问答 查询重写 查询重写+图谱增强检索 图谱提供结构化证据增强 侧重重写与图谱增强;实验设置与本研究不同
LightRAG[9] 通用RAG 关键词抽取 低层实体+高层关系检索 组织实体与关系候选 通用框架;受图谱连通性和关系质量约束
本研究方法 水稻种植问答 领域LoRA-HyDE;通用/Few-shot诊断 LightRAG+文本块+字符n-gram BM25融合 当前稀疏图谱上仅提供有限关系辅助 侧重查询端术语补充与同域工程诊断;不代表跨来源泛化
为检验网页端大模型评分的批次稳定性,本研究从RCOQ-H100中固定选取20道题,保持匿名回答、评分提示词和评价维度不变,由三位大模型评委分别重复完成3轮独立评分,并计算三轮评分总体均值的批间方差、标准差以及题目级ICC(3,1)。结果见表15。
表 15 网页大模型重复评分的批次稳定性诊断(固定20题匿名子集)

Table 15 Batch-stability diagnostic of repeated web-model scoring on 20 fixed blinded items

评委模型 三轮总体均值/分 批间方差/分² 批间标准差/分 组内相关系数ICC(3,1)
Gemini 3.5 Flash 3.263 / 3.547 / 3.463 0.021 2 0.145 6 0.896
GPT-5.6 Sol 3.163 / 2.960 / 2.950 0.014 5 0.120 4 0.901
DeepSeek-V4-Flash 3.187 / 2.863 / 2.890 0.032 2 0.179 5 0.737
三位大模型评委的ICC(3,1)为0.737~0.901,表明固定匿名子集上的重复评分具有一定稳定性;但不同批次的总体均值仍存在波动,因此本研究仅将网页端大模型评分作为专家评价的辅助证据。
独立60题诊断的分层覆盖与检索结果见表16。本研究还在生成系统答案前独立构建了60题平衡诊断,其中0-hop、1-hop和2-hop+各20题,用于在受控层级分布下检查关系信息;该诊断不是对RCOQ-H100的重新标注,也不能单独证明RCOQ-H100未回避复杂问题。RCOQ-H100的实际59/2/39构成和分层复核在后文另行报告。诊断中的2-hop+仅表示由两条相邻关系支持的关联证据整合,不代表通用多步因果推理。
表16 独立60题关系跳数分层覆盖与Top-8检索诊断

Table 16 Hop-stratified coverage and Top-8 retrieval diagnostic on the independent 60-question set

跳数层级 题数/题(占比/%) 预定义图路径覆盖率/% “实体—文本”Recall@8 关系增强Recall@8 ΔRecall@8 [95% CI]
0-hop 20(33.3) 100 0.875 0.910 0.035 [0.000, 0.095]
1-hop 20(33.3) 100 0.900 0.950 0.050 [0.000, 0.150]
2-hop+ 20(33.3) 100 0.713 0.796 0.083 [0.000, 0.217]
总体 60(100) 100 0.829 0.885 0.056 [0.012, 0.117]
表16中,题数以题计,占比与路径覆盖率以百分数表示;Recall@8及其增量为无量纲数值,置信区间与增量采用同一尺度。表16显示,60题平衡诊断中三个层级的预定义路径与绑定来源块的覆盖率均为100%,说明该独立诊断没有省略1-hop和2-hop+问题;但它不代表RCOQ-H100的自然构成。关系增强总体Recall@8上升0.056(95%置信区间为[0.012,0.117]),2-hop+增量区间下界为0,仅支持有限关系信息辅助。RCOQ-H100的固定条件消融结果见表17:关系增强总体Recall@8仅比“实体—文本”基线高0.022 5,95% bootstrap区间[0.000 0,0.055 0];总体NDCG@8增量为0.036 9,区间[0.010 5,0.070 0]。因此,当前证据最多支持关系通道提供有限排序信号,不支持稳定多跳推理或“协同召回显著提升”。
表17 RCOQ-H100关系跳数覆盖与Top-8检索复核

Table 17 Hop-stratified coverage and Top-8 retrieval re-evaluation on RCOQ-H100

跳数层级 题数/题(占比/%) 金源块图关联覆盖率/% LightRAG Recall@8 固定词法融合Recall@8 固定条件关系通道消融 ΔRecall@8 [95% CI]
0-hop 59(59) 100 0.525 0.678 0.016 9 [0.000 0, 0.050 8]
1-hop 2(2) 100 0.250 0.250 0.000 0 [0.000 0, 0.000 0]
2-hop+ 39(39) 100 0.466 0.618 0.032 1 [0.000 0, 0.089 7]
总体 100(100) 100 0.497 0.646 0.022 5 [0.000 0, 0.055 0]

注:题目、参考要点、金源块、关系路径及跳数标签已由农学专家逐题核定并冻结;本表Recall@8及其增量均为无量纲指标。最后一列为固定条件关系通道消融的Recall@8增量及其95%置信区间,并非前两列Recall@8数值之差。1-hop仅2题,不作层间显著性推断。固定词法融合与标准方法的总上下文预算并非完全一致,故其差异用于工程复核;关系通道边际贡献以最后一列固定条件消融为准。

为补充人工评分之外的客观诊断,本研究在RCOQ-H100的100×5主方法回答包上重新计算字符级ROUGE-L F1和中文BERTScore-F1,结果见表18。此处“领域HyDE+LightRAG”指包含固定词法融合的最终工程管线;不含词法融合的领域HyDE仅用于检索诊断。两项指标衡量与专家核定参考要点的词面或语义重合,不等同于独立农学正确性、检索相关性或证据忠实度。
表18 RCOQ-H100回答与参考要点重合度复核

Table 18 Reference-keypoint overlap re-evaluation on RCOQ-H100

方法 ROUGE-L F1(无量纲) BERTScore-F1(无量纲)
Naive RAG 0.181 0.659
LightRAG 0.259 0.700
通用HyDE+LightRAG 0.249 0.693
Few-shot HyDE+LightRAG 0.253 0.694
领域HyDE+LightRAG(固定词法融合) 0.241 0.693
固定词法融合领域HyDE+LightRAG管线相对LightRAG的ROUGE-L差异为-0.018 2,95% bootstrap区间[-0.038 1,0.001 7],Cohen's dz=-0.177;BERTScore-F1差异为-0.007 6,区间[-0.017 2,0.002 0],dz=-0.153。通用HyDE和Few-shot HyDE相对LightRAG的两项置信区间也均跨0。Naive RAG相对LightRAG的ROUGE-L和BERTScore-F1差异分别为-0.078 6(95%置信区间为[-0.102 5,-0.055 8])和-0.041 0(95% bootstrap置信区间为[-0.052 2,-0.030 4])。因此,固定词法融合虽改善了RCOQ-H100的金源块召回与排序,但没有转化为更高的参考要点重合度;这可能涉及新增证据稀释、生成阶段对新增证据利用不足或指标对表达方式敏感,现有实验不能区分上述机制。

3 结 论

本研究围绕水稻种植智能问答中的查询表达不足问题,构建并诊断了领域HyDE与LightRAG结合的检索增强生成流程。根据RCOQ-H100的既有盲评与分层复核,以及独立60题平衡诊断,本研究将贡献定位为查询端语义增强、固定词法融合和实验诊断三个方面的工程实现,不将既有LightRAG能力或高层图关系推理作为新增贡献。主要结论如下:
(1)既有盲评批次中,领域LoRA-HyDE相对LightRAG的主观均分高0.115分,但95%置信区间跨0,Holm校正后p=0.903,dz=0.118。RCOQ-H100分层检索复核中,通用HyDE、Few-shot HyDE及不含固定词法融合的领域HyDE总体Recall@8均未高于LightRAG。因此,HyDE查询改写本身未显示稳定优势,可能引入查询漂移或无关信息。
(2)LightRAG相对Naive RAG贡献了主要增益,但该能力属于既有LightRAG框架。RCOQ-H100复核中,固定词法融合领域管线提高了金源块Recall@8与NDCG@8,却未提高ROUGE-L或BERTScore;由于上下文预算控制并非完全一致,该增益只能归于工程整体,不能归因于HyDE单独贡献或高层关系推理。
(3)图谱平均度为2.310、孤立节点为14.732%、聚类系数为0.032 5,且LightRAG运行投影与Neo4j审计投影并不等价。RCOQ-H100固定条件消融中,关系通道Recall@8增量为0.022 5且区间触及0,仅NDCG@8呈有限正向信号;当前证据不支持“关系协同召回显著提升”或稳定多跳推理。102条LoRA训练样本下,领域LoRA-HyDE与Few-shot HyDE差异也不显著,资源受限时Few-shot仍是更低成本的替代方案。
综上,本研究构建了“领域知识支撑—查询语义补充—证据检索—受控生成”的工程流程,但结论受图谱稀疏与碎片化、102/14/17条LoRA训练/验证/测试规模、同域评测、RCOQ-H100中1-hop仅2题、独立60题诊断与部分替换题存在来源块共享,以及核定后的系统答案尚未另行开展人工盲评等因素约束。后续应扩展未见来源测试、统一上下文预算,并在更致密且独立审计的图谱上验证关系检索;若需对核定后的新答案作主观方法比较,则应另行完成盲评。

本研究不存在研究者以及与公开研究成果有关的利益冲突。

[1]
张洪程, 胡雅杰, 杨建昌, 等. 中国特色水稻栽培学发展与展望[J]. 中国农业科学, 2021, 54(7): 1301-1321.

ZHANG H C, HU Y J, YANG J C, et al. Development and prospect of rice cultivation in China[J]. Scientia Agricultura Sinica, 2021, 54(7): 1301-1321.

[2]
刘烨宸, 李华昱. 领域知识图谱研究综述[J]. 计算机系统应用, 2020, 29(6): 1-12.

LIU Y C, LI H Y. Survey on domain knowledge graph research[J]. Computer Systems & Applications, 2020, 29(6): 1-12.

[3]
LEWIS P, PEREZ E, PIKTUS A, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks[C]//Proceedings of the 34th International Conference on Neural Information Processing Systems (NeurIPS 2020). Red Hook, NY, USA: Curran Associates, Inc., 2020: 9459-9474.

[4]
XIONG G Z, JIN Q, LU Z Y, et al. Benchmarking retrieval-augmented generation for medicine[C]//Findings of the Association for Computational Linguistics: ACL 2024. Stroudsburg, PA, USA: Association for Computational Linguistics, 2024: 6233-6251.

[5]
PIPITONE N, ALAMI G H. LegalBench-RAG: a benchmark for retrieval-augmented generation in the legal domain[PP/OL]. arXiv (2024-08-19)[2026-09-20].

[6]
LI Z X, WANG Z J, WANG W M, et al. Retrieval-augmented generation for educational application: a systematic survey[J]. Computers and Education: Artificial Intelligence, 2025, 8: 100417.

[7]
GAO Y F, XIONG Y, GAO X Y, et al. Retrieval-augmented generation for large language models: a survey[PP/OL]. V5. arXiv (2024-03-27)[2026-09-20].

[8]
EDGE D, TRINH H, CHENG N, et al. From local to global: a graph RAG approach to query-focused summarization[PP/OL]. V2. arXiv (2025-02-19)[2026-09-20].

[9]
GUO Z R, XIA L H, YU Y H, et al. LightRAG: simple and fast retrieval-augmented generation[C]//Findings of the Association for Computational Linguistics: EMNLP 2025. Stroudsburg, PA, USA: Association for Computational Linguistics, 2025: 10746-10761.

[10]
SARMAH B, HALL B, RAO R, et al. HybridRAG: integrating knowledge graphs and vector retrieval augmented generation for efficient information extraction[PP/OL]. arXiv (2024-08-09)[2026-09-20].

[11]
GAO L Y, MA X G, LIN J, et al. Precise zero-shot dense retrieval without relevance labels[C]//Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers). Stroudsburg, PA, USA: Association for Computational Linguistics, 2023: 1762-1777.

[12]
HU E J, SHEN Y L, WALLIS P, et al. LoRA: low-rank adaptation of large language models[C]//Proceedings of the Tenth International Conference on Learning Representations (ICLR 2022), 2022.

[13]
ZHANG Q R, CHEN M S, BUKHARIN A, et al. Adaptive budget allocation for parameter-efficient fine-tuning[C]//11th International Conference on Learning Representations (ICLR 2023), 2023.

[14]
吴春志, 赵玉龙, 刘鑫, 等. 大语言模型微调方法研究综述[J]. 中文信息学报, 2025, 39(2): 1-26.

WU C Z, ZHAO Y L, LIU X, et al. Fine tuning methods for large language models: a survey[J]. Journal of Chinese Information Processing, 2025, 39(2): 1-26.

[15]
QWEN, YANG A, YANG B S, et al. Qwen2.5 technical report[PP/OL]. V2. arXiv (2025-01-03)[2026-09-20].

[16]
GUU K, LEE K, TUNG Z, et al. Retrieval augmented language model pre-training[C]//Proceedings of the 37th International Conference on Machine Learning. PMLR, 2020: 3929-3938.

[17]
JEONG S, BAEK J, CHO S, et al. Adaptive-RAG: learning to adapt retrieval-augmented large language models through question complexity[C]//Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers). Stroudsburg, PA, USA: Association for Computational Linguistics, 2024: 7036-7050.

[18]
MA X B, GONG Y Y, HE P C, et al. Query rewriting in retrieval-augmented large language models[C]//Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing. Stroudsburg, PA, USA: Association for Computational Linguistics, 2023: 5303-5315.

[19]
LIN J, MA X G, LIN S C, et al. Pyserini: An easy-to-use Python toolkit to support replicable IR research with sparse and dense representations[PP/OL]. arXiv (2021-02-19)[2026-09-21].

[20]
NOGUEIRA R, CHO K. Passage re-ranking with BERT[PP/OL]. V5. arXiv (2020-04-14)[2026-09-20].

[21]
ASAI A, WU Z Q, WANG Y Z, et al. Self-RAG: learning to retrieve, generate, and critique through self-reflection[C]//The Twelfth International Conference on Learning Representations (ICLR 2024). 2024.

[22]
ES S, JAMES J, ESPINOSA ANKE L, et al. RAGAs: automated evaluation of retrieval augmented generation[C]//Proceedings of the 18th Conference of the European Chapter of the Association for Computational Linguistics: System Demonstrations. Stroudsburg, PA, USA: Association for Computational Linguistics, 2024: 150-158.

[23]
SHAO Z H, GONG Y Y, SHEN Y L, et al. Enhancing retrieval-augmented large language models with iterative retrieval-generation synergy[C]//Findings of the Association for Computational Linguistics: EMNLP 2023. Stroudsburg, PA, USA: Association for Computational Linguistics, 2023: 9248-9274.

[24]
李晓雨, 张佳仪, 张海涛, 等. ReG-RAG:融合查询重写与图谱增强的大模型问答生成方法[J/OL]. 智慧农业(中英文), 2025[2026-09-29].

LI X Y, ZHANG J Y, ZHANG H T, et al. ReG-RAG: A large language model-based question answering framework with query rewriting and knowledge graph enhancement[J/OL]. Smart Agriculture, 2025[2026-09-29].

[25]
杨俊, 杨婉霞, 杨森, 等. 自适应混合检索增强大模型的农作物病虫害智能问答方法[J]. 智慧农业(中英文), 2026, 8(1): 52-61.

YANG J, YANG W X, YANG S, et al. Intelligent Q & a method for crop diseases and pests using LLM augmented by adaptive hybrid retrieval[J]. Smart Agriculture, 2026, 8(1): 52-61.

[26]
PENG B C, ZHU Y, LIU Y C, et al. Graph retrieval-augmented generation: a survey[PP/OL]. V2. arXiv (2024-09-10)[2026-09-20].

[27]
DETTMERS T, PAGNONI A, HOLTZMAN A, et al. QLoRA: Efficient Finetuning of Quantized LLMs[C]//Advances in Neural Information Processing Systems (NeurIPS 2023). Red Hook, NY, USA: Curran Associates, Inc., 2023: 10088-10115.

[28]
LIU S Y, WANG C Y, YIN H X, et al. DoRA: weight-decomposed low-rank adaptation[C]//Proceedings of the 41st International Conference on Machine Learning. PMLR, 2024: 32100-32121.

[29]
SINGHAL K, AZIZI S, TU T, et al. Large language models encode clinical knowledge[J]. Nature, 2023, 620(7972): 172-180.

[30]
CUI J X, NING M N, LI Z J, et al. Chatlaw: a multi-agent legal assistant based on a role-aligned mixture-of-experts architecture[PP/OL]. V3. arXiv (2026-06-08)[2026-09-20].

[31]
WU S J, IRSOY O, LU S, et al. BloombergGPT: a large language model for finance[PP/OL]. V3. arXiv (2023-12-21)[2026-09-20].

[32]
CHEN J L, XIAO S T, ZHANG P T, et al. M3-embedding: multi-linguality, multi-functionality, multi-granularity text embeddings through self-knowledge distillation[PP/OL]. V5. arXiv (2025-12-12)[2026-09-20].

[33]
DEEPSEEK-AI, XU A Y, LIN B C, et al. DeepSeek-V4: towards highly efficient million-token context intelligence[PP/OL]. arXiv (2026-04-26)[2026-07-17].

文章导航

/

〈 〉